이 선들이 전체 선에 대한 신뢰 구간을 형성한다고 생각하기 쉽습니다. 하지만 이는 사실이 아닙니다. 문제는 상한 및 하한 신뢰 한계가 한 번에 하나의 점만을 사용하여 계산된다는 점입니다. 선 전체에 대한 신뢰 구간을 계산하려면, 해당 선에 대해 상수(constant)와 X의 계수라는 두 가지 매개변수가 계산되고 있다는 사실을 고려해야 합니다. 따라서 전체 선에 대한 상한 및 하한 신뢰 구간은 다음과 같이 주어집니다:
BASIC
LET n=48
LET nvars=2
LET upperband = estimate+SQRT(2*FIF(.95,2,n-nvars))*sepred
LET lowerband = estimate+SQRT(2*FIF(.95,2,n-nvars))*sepred
PRINT upperband lowerband
RUN
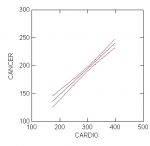
 CANCER의 추정값에 대한 신뢰 구간과 회귀선의 신뢰 구간을 플롯하면 신뢰 구간보다 신뢰 구간이 더 넓다는 것을 알 수 있습니다:
BEGIN
PLOT cancer*x(1) / SIZE=0 SMOOTH=LINEAR SHORT YMIN=100 YMAX=300,
XMIN=100 XMAX=500 XLABEL=’CARDIO’ COLOR=BLUE
PLOT upper,lower*x(1) /SIZE=0 SMOOTH=SPLINE SHORT YMIN=100,
YMAX=300 XMIN=100 XMAX=500 YLABEL=’ ‘,
XLABEL=’ ‘ COLOR=RED OVERLAY
PLOT upperband,lowerband*x(1) /SIZE=0 SMOOTH=SPLINE SHORT,
YMIN=100 YMAX=300 XMIN=100 XMAX=500 YLABEL=’ ‘,
XLABEL=’ ‘ COLOR=GREEN OVERLAY
END
 CANCER의 추정값에 대한 신뢰 구간과 회귀선의 신뢰 구간을 플롯하면 신뢰 구간보다 신뢰 구간이 더 넓다는 것을 알 수 있습니다:
BEGIN
PLOT cancer*x(1) / SIZE=0 SMOOTH=LINEAR SHORT YMIN=100 YMAX=300,
XMIN=100 XMAX=500 XLABEL=’CARDIO’ COLOR=BLUE
PLOT upper,lower*x(1) /SIZE=0 SMOOTH=SPLINE SHORT YMIN=100,
YMAX=300 XMIN=100 XMAX=500 YLABEL=’ ‘,
XLABEL=’ ‘ COLOR=RED OVERLAY
PLOT upperband,lowerband*x(1) /SIZE=0 SMOOTH=SPLINE SHORT,
YMIN=100 YMAX=300 XMIN=100 XMAX=500 YLABEL=’ ‘,
XLABEL=’ ‘ COLOR=GREEN OVERLAY
END
암(암으로 인한 10만 명당 사망자 수)과 심혈관 질환(심혈관 질환으로 인한 10만 명당 사망자 수)의 관계는 선형이기 때문에 암의 추정값에 대한 신뢰 구간과 회귀선의 신뢰 구간 간의 차이는 작지만, 이와 같이 잘 처리된 데이터에서도 그 차이는 분명합니다.
둘째, 모든 관측값의 95%가 신뢰 구간 내에 속해야 한다고 생각하는 경향이 있습니다. 이 또한 사실이 아닙니다. 이는 평균에 대한 신뢰 구간일 뿐입니다. 관측값에 대한 신뢰 구간을 찾으려면 아래에서 보는 것처럼 계산을 수정해야 합니다.
BASIC
LET n=48
LET nvars=2
LET s_square=177.065
LET upperband = estimate+TIF(.975,n-nvars)*SQR(sepred^2+s_square)
LET lowerband = estimate-TIF(.975,n-nvars)*SQR(sepred^2+s_square)
PRINT upperband lowerband
RUN
여기서 S_SQUARE는 회귀의 평균 제곱 잔차값입니다. 이를 예측 구간이라고도 합니다. N 및 NVARS 값을 입력할 때 회귀 출력의 분산 분석 테이블에 있는 S_SQUARE 값도 입력합니다.
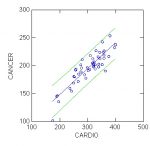
이제 이 계산의 결과를 보려면 다음 명령어를 실행합니다:
BEGIN
PLOT cancer*x(1) /SMOOTH=LINEAR SHORT YMIN=100 YMAX=300 XMIN=100,
XMAX=500 XLABEL=’CARDIO’ COLOR=BLUE
PLOT upperband,lowerband*x(1) / SIZE=0 SMOOTH=SPLINE SHORT,
YMIN=100 YMAX=300 XMIN=100 XMAX=500 YLABEL=’ ‘,
XLABEL=’ ‘ COLOR=GREEN OVERLAY
END
이렇게 하면 데이터 주위에 신뢰 구간 또는 예측 구간이 그려집니다.
 BEGIN
PLOT cancer*x(1) /SMOOTH=LINEAR SHORT YMIN=100 YMAX=300 XMIN=100,
XMAX=500 XLABEL=’CARDIO’ COLOR=BLUE
PLOT upperband,lowerband*x(1) / SIZE=0 SMOOTH=SPLINE SHORT,
YMIN=100 YMAX=300 XMIN=100 XMAX=500 YLABEL=’ ‘,
XLABEL=’ ‘ COLOR=GREEN OVERLAY
END
이렇게 하면 데이터 주위에 신뢰 구간 또는 예측 구간이 그려집니다.