On pourrait être tenté de penser que ces lignes forment une bande de confiance pour l’ensemble de la courbe. Ce n’est pas le cas. Le problème réside dans le fait que les limites de confiance supérieure et inférieure sont calculées en utilisant un point à la fois. Afin de calculer une bande ou un intervalle de confiance pour une droite entière, il faut tenir compte du fait que deux paramètres, la constante et le coefficient de X, sont calculés pour cette droite. Par conséquent, les limites supérieure et inférieure de la fourchette de confiance pour la courbe dans son ensemble seraient données par :
BASIC
LET n=48
LET nvars=2
LET upperband = estimate+SQRT(2*FIF(.95,2,n-nvars))*sepred
LET lowerband = estimate+SQRT(2*FIF(.95,2,n-nvars))*sepred
PRINT upperband lowerband
RUN
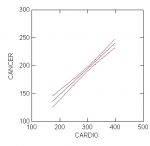
 Lorsque vous représentez les intervalles de confiance pour les valeurs estimées de CANCER et les bandes de confiance pour la ligne de régression, vous verrez que la bande de confiance est plus large que l’intervalle de confiance :
BEGIN
PLOT cancer*x(1) / SIZE=0 SMOOTH=LINEAR SHORT YMIN=100 YMAX=300 ,
XMIN=100 XMAX=500 XLABEL=’CARDIO’ COLOR=BLUE
PLOT upper,lower*x(1) /SIZE=0 SMOOTH=SPLINE SHORT YMIN=100,
YMAX=300 XMIN=100 XMAX=500 YLABEL=’ ‘,
XLABEL=’ ‘ COLOR=RED OVERLAY
PLOT upperband,lowerband*x(1) /SIZE=0 SMOOTH=SPLINE SHORT,
YMIN=100 YMAX=300 XMIN=100 XMAX=500 YLABEL=’ ‘,
XLABEL=’ ‘ COLOR=GREEN OVERLAY
END
 Lorsque vous représentez les intervalles de confiance pour les valeurs estimées de CANCER et les bandes de confiance pour la ligne de régression, vous verrez que la bande de confiance est plus large que l’intervalle de confiance :
BEGIN
PLOT cancer*x(1) / SIZE=0 SMOOTH=LINEAR SHORT YMIN=100 YMAX=300 ,
XMIN=100 XMAX=500 XLABEL=’CARDIO’ COLOR=BLUE
PLOT upper,lower*x(1) /SIZE=0 SMOOTH=SPLINE SHORT YMIN=100,
YMAX=300 XMIN=100 XMAX=500 YLABEL=’ ‘,
XLABEL=’ ‘ COLOR=RED OVERLAY
PLOT upperband,lowerband*x(1) /SIZE=0 SMOOTH=SPLINE SHORT,
YMIN=100 YMAX=300 XMIN=100 XMAX=500 YLABEL=’ ‘,
XLABEL=’ ‘ COLOR=GREEN OVERLAY
END
Comme la relation entre CANCER (décès par 100 000 dus au cancer) et CARDIO (décès par 100 000 dus aux maladies cardiovasculaires) est linéaire, la différence entre les intervalles de confiance pour les valeurs estimées de CANCER et les intervalles de confiance pour la ligne de régression est faible, mais même avec des données qui se comportent bien comme celle-ci, la différence est apparente.
Deuxièmement, il est également tentant de penser que 95 % de toutes les observations devraient se situer à l’intérieur des intervalles de confiance. Ce n’est pas vrai non plus. Il s’agit de bandes de confiance pour la moyenne uniquement. Si vous souhaitez trouver des bandes de confiance pour les observations, vous devez modifier le calcul comme indiqué ci-dessous.
BASIC
LET n=48
LET nvars=2
LET s_square=177,065
LET upperband = estimate+TIF(0,975; n-nvars)*SQR(sepred^2+s_square)
LET lowerband = estimate-TIF(.975,n-nvars)*SQR(sepred^2+s_square)
PRINT upperband lowerband
RUN
où S_SQUARE est le résidu quadratique moyen de la régression. Ces intervalles sont parfois appelés intervalles de prédiction. Lorsque vous saisissez les valeurs de N et NVARS, saisissez également la valeur de S_SQUARE, que vous trouverez dans le tableau d’analyse de la variance du résultat de la régression.
Maintenant, si vous souhaitez voir les résultats de ce calcul, lancez la séquence de commandes suivante :
BEGIN
PLOT cancer*x(1) /SMOOTH=LINEAR SHORT YMIN=100 YMAX=300 XMIN=100,
XMAX=500 XLABEL=’CARDIO’ COLOR=BLUE
PLOT upperband,lowerband*x(1) / SIZE=0 SMOOTH=SPLINE SHORT,
YMIN=100 YMAX=300 XMIN=100 XMAX=500 YLABEL=’ ‘,
XLABEL=’ ‘ COLOR=GREEN OVERLAY
END
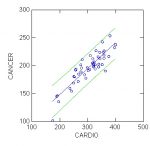
Cela permet de tracer les bandes de confiance ou les intervalles de prédiction autour des données.
 BEGIN
PLOT cancer*x(1) /SMOOTH=LINEAR SHORT YMIN=100 YMAX=300 XMIN=100,
XMAX=500 XLABEL=’CARDIO’ COLOR=BLUE
PLOT upperband,lowerband*x(1) / SIZE=0 SMOOTH=SPLINE SHORT,
YMIN=100 YMAX=300 XMIN=100 XMAX=500 YLABEL=’ ‘,
XLABEL=’ ‘ COLOR=GREEN OVERLAY
END
Cela permet de tracer les bandes de confiance ou les intervalles de prédiction autour des données.