Grafiti S.L.

Bandas de confianza

Intervalos de confianza y bandas de confianza

Conceptos básicos

A veces nos preguntan cómo obtener intervalos de confianza en modelos lineales con Grafiti. En realidad, no es muy difícil y, aquí, vamos a repasar la técnica. Pero antes de eso, repasemos las ideas básicas que hay detrás de un intervalo de confianza para un modelo lineal.

En primer lugar, si tenemos una regresión lineal de Y sobre la variable X, en realidad estamos diciendo que, para un valor dado de X, el valor de Y viene dado por Y=aX+b+e donde e es un “término de ruido”.

Se suele suponer que el término de ruido se distribuye normalmente con una media de 0 y una varianza de s^2. El truco para un conjunto de datos reales es estimar a y b y luego realizar inferencias sobre esas estimaciones utilizando un valor estimado de s^2.

A veces, sin embargo, nos gustaría encontrar un intervalo de confianza para la media de Y en un valor específico de X. Según la ecuación anterior, la media de Y en X es aX+b.

Sin embargo, en un conjunto de datos reales, nunca conocemos los valores “verdaderos” de a y b; todo lo que sabemos son nuestras estimaciones. Por lo tanto, conviene encontrar un intervalo en el que podamos estar relativamente seguros de que se da la verdadera media de Y.

Existen fórmulas muy complicadas para calcular este intervalo, pero no vamos a entrar en ellas. Al fin y al cabo, el ordenador debe facilitar el cálculo. Así, supongamos que tomamos el conjunto de datos de muestra USSTATES.SYD, con 48 casos válidos para las variables CARDIO y CÁNCER. Utilice el cuadro de diálogo Estadísticas > Regresión > Lineal para configurar el modelo de regresión o emitir los comandos:

REGRESS
USE usstates
SAVE regress/MODEL
MODEL cancer=CONSTANT+cardio
ESTIMATE

El ordenador estimará entonces el modelo, encontrando valores estimados tanto para la constante como para el coeficiente de CARDIO e imprimiendo una tabla de análisis de varianza.

En este caso también guardará un archivo, REGRESS.SYD, que contiene los residuos del modelo, estimaciones de CANCER basadas en CARDIO para el modelo (la variable llamada ESTIMATE) y un valor misterioso llamado SEPRED. Es SEPRED lo que utilizaremos para calcular nuestros intervalos de confianza.

SEPRED es la sigla de “Standard Error of the Predicted Value” (error estándar del valor previsto). El archivo también tendrá los valores de los datos originales. Se guardan porque hemos añadido la opción MODELO al comando GUARDAR.

Para calcular los límites SUPERIOR e INFERIOR de un intervalo de confianza del 95 % para los valores previstos de CANCER, usa el cuadro de diálogo «Data» > «Transform» > «Let» o entra en el módulo BASIC y ejecuta los comandos:
BASIC
USE regress
LET n=48
LET nvars=2
LET upper = estimate+TIF(.975,n-nvars)*sepred
LET lower = estimate-TIF(.975,n-nvars)*sepred
PRINT upper lower
RUN

A continuación, se imprimirán los límites de confianza SUPERIOR e INFERIOR del valor estimado de CÁNCER para cada caso. En lo anterior, TIF significa “distribución t inversa”.

Las ideas anteriores pueden generalizarse de varias maneras. Por ejemplo, si desea encontrar un intervalo de confianza para la media de Y para una regresión sobre dos variables, sólo tiene que añadir esas variables a la sentencia MODEL en REGRESS y cambiar NVARS de 2 a 3 en el módulo BASIC. (Nota: N-NVARS representa el número de casos válidos menos el número de variables del modelo. Ajuste N y NVARS al número correcto de casos y variables para su modelo.

Intervalos de confianza para la media de Y con nuevos valores de X

Puede ocurrir que desee encontrar el intervalo de confianza para la media de Y en uno o más valores nuevos de su variable X. Ponga los nuevos valores de X al final de su fichero y haga cero los valores de Y asociados. (No tiene que preocuparse de cuál es el valor Y en realidad. Este valor Y es sólo un marcador de posición y no entrará en los cálculos).

A continuación, añade una nueva variable en tu archivo llamada WT. WT debe tener el valor 1 para los casos en los que tiene datos tanto para X como para Y, y 0 para los casos con nuevos valores de X. Después de guardar el archivo, utilice el cuadro de diálogo Data > Frequency para seleccionar WT como su variable de ponderación, o emita el comando:

FRECUENCIA=WT

Utilizando el cuadro de diálogo Estadísticas > Regresión > Lineal o un archivo de comandos, estime de nuevo su modelo de regresión, recordando guardar los resultados en un archivo de datos con la opción MODELO. El comando FRECUENCIA es muy útil en este contexto; al calcular la regresión, los puntos con peso 1 se utilizarán una vez, los puntos con peso cero se utilizarán cero veces.

Así, la regresión se calculará para los casos con valores conocidos de Y y X. Sin embargo, el valor de ESTIMACIÓN se calculará para todos los casos. Utilizando el archivo de resultados guardados, puede utilizar el cálculo anterior para derivar el intervalo de confianza para la media estimada de una Y desconocida en un valor conocido de X para los nuevos casos.

Sutilezas

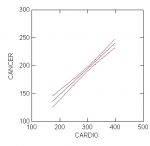
Hay un par de matices sobre este tipo de intervalo de confianza que debes tener en cuenta. En primer lugar, se trata de un intervalo para la media de Y en un valor concreto de X, no de un intervalo de confianza ni de una banda para la recta de regresión. Si trazas los límites de confianza SUPERIOR e INFERIOR, verás dos líneas curvas a ambos lados de la línea de regresión. Volviendo al ejemplo original con el archivo USSTATES.SYD, calcula los valores del intervalo de confianza y traza el gráfico: BEGIN PLOT cancer*x(1) /SIZE=0 SMOOTH=LINEAR SHORT YMIN=100 YMAX=300, XMIN=100 XMAX=500 XLABEL=’CARDIO’ COLOR=BLUE PLOT upper,lower*x(1) /SIZE=0 SMOOTH=SPLINE SHORT YMIN=100 YMAX=300, XMIN=100 XMAX=500 YLABEL=’ ‘ XLABEL=’ ‘ COLOR=RED, OVERLAY END (Al guardar los resultados del modelo estimado, SYSTAT cambia el nombre de las variables independientes X(1). . . X(n), de modo que CARDIO pasa a llamarse X(1) en este ejemplo).
Es tentador pensar que estas líneas forman una banda de confianza para toda la línea. Pero eso no es cierto. El problema es que los límites de confianza superior e inferior se calculan usando un punto cada vez. Para calcular una banda o intervalo de confianza para toda una línea, tenemos que tener en cuenta que para esa línea se calculan dos parámetros: la constante y el coeficiente de X. Por lo tanto, las bandas de confianza superior e inferior para toda la línea vendrían dadas por: BASIC LET n=48 LET nvars=2 LET upperband = estimate+SQRT(2*FIF(.95,2,n-nvars))*sepred LET lowerband = estimate+SQRT(2*FIF(.95,2,n-nvars))*sepred PRINT upperband lowerband RUN Al trazar los intervalos de confianza de los valores estimados de CÁNCER y las bandas de confianza de la recta de regresión, se observa que la banda de confianza es más ancha que el intervalo de confianza: BEGIN PLOT cancer*x(1) / SIZE=0 SMOOTH=LINEAR SHORT YMIN=100 YMAX=300 , XMIN=100 XMAX=500 XLABEL=’CARDIO’ COLOR=BLUE PLOT upper,lower*x(1) /SIZE=0 SMOOTH=SPLINE SHORT YMIN=100, YMAX=300 XMIN=100 XMAX=500 YLABEL=’ ‘, XLABEL=’ ‘ COLOR=RED OVERLAY PLOT upperband,lowerband*x(1) /SIZE=0 SMOOTH=SPLINE SHORT, YMIN=100 YMAX=300 XMIN=100 XMAX=500 YLABEL=’ ‘, XLABEL=’ ‘ COLOR=GREEN OVERLAY END
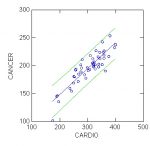
Dado que la relación entre CANCER (muertes por 100.000 debidas al cáncer) y CARDIO (muertes por 100.000 debidas a enfermedades cardiovasculares) es lineal, la diferencia entre los intervalos de confianza para los valores estimados de CANCER y las bandas de confianza para la línea de regresión es pequeña, pero incluso con datos de buen comportamiento como éste la diferencia es aparente. En segundo lugar, también es tentador pensar que el 95% de todas las observaciones deberían estar dentro de las bandas de confianza. Esto tampoco es cierto. Se trata de bandas de confianza sólo para la media. Si desea hallar bandas de confianza para las observaciones, deberá modificar el cálculo como se indica a continuación. BASIC LET n=48 LET nvars=2 LET s_square=177.065 LET upperband = estimate+TIF(.975,n-nvars)*SQR(sepred^2+s_square) LET lowerband = estimate-TIF(.975,n-nvars)*SQR(sepred^2+s_square) PRINT upperband lowerband RUN
donde S_CUADRADO es el residuo cuadrático medio de la regresión. A veces se denominan intervalos de predicción. Cuando introduzca sus valores para N y NVARS, introduzca también el valor para S_CUADRADO, que encontrará en la tabla de Análisis de Varianza del resultado de la regresión. Ahora, si desea ver los resultados de este cálculo, emita la siguiente secuencia de comandos: BEGIN PLOT cancer*x(1) /SMOOTH=LINEAR SHORT YMIN=100 YMAX=300 XMIN=100, XMAX=500 XLABEL=’CARDIO’ COLOR=BLUE PLOT upperband,lowerband*x(1) / SIZE=0 SMOOTH=SPLINE SHORT, YMIN=100 YMAX=300 XMIN=100 XMAX=500 YLABEL=’ ‘, XLABEL=’ ‘ COLOR=GREEN OVERLAY END Esto trazará las bandas de confianza o intervalos de predicción alrededor de los datos.
Carrito de compra
Scroll al inicio